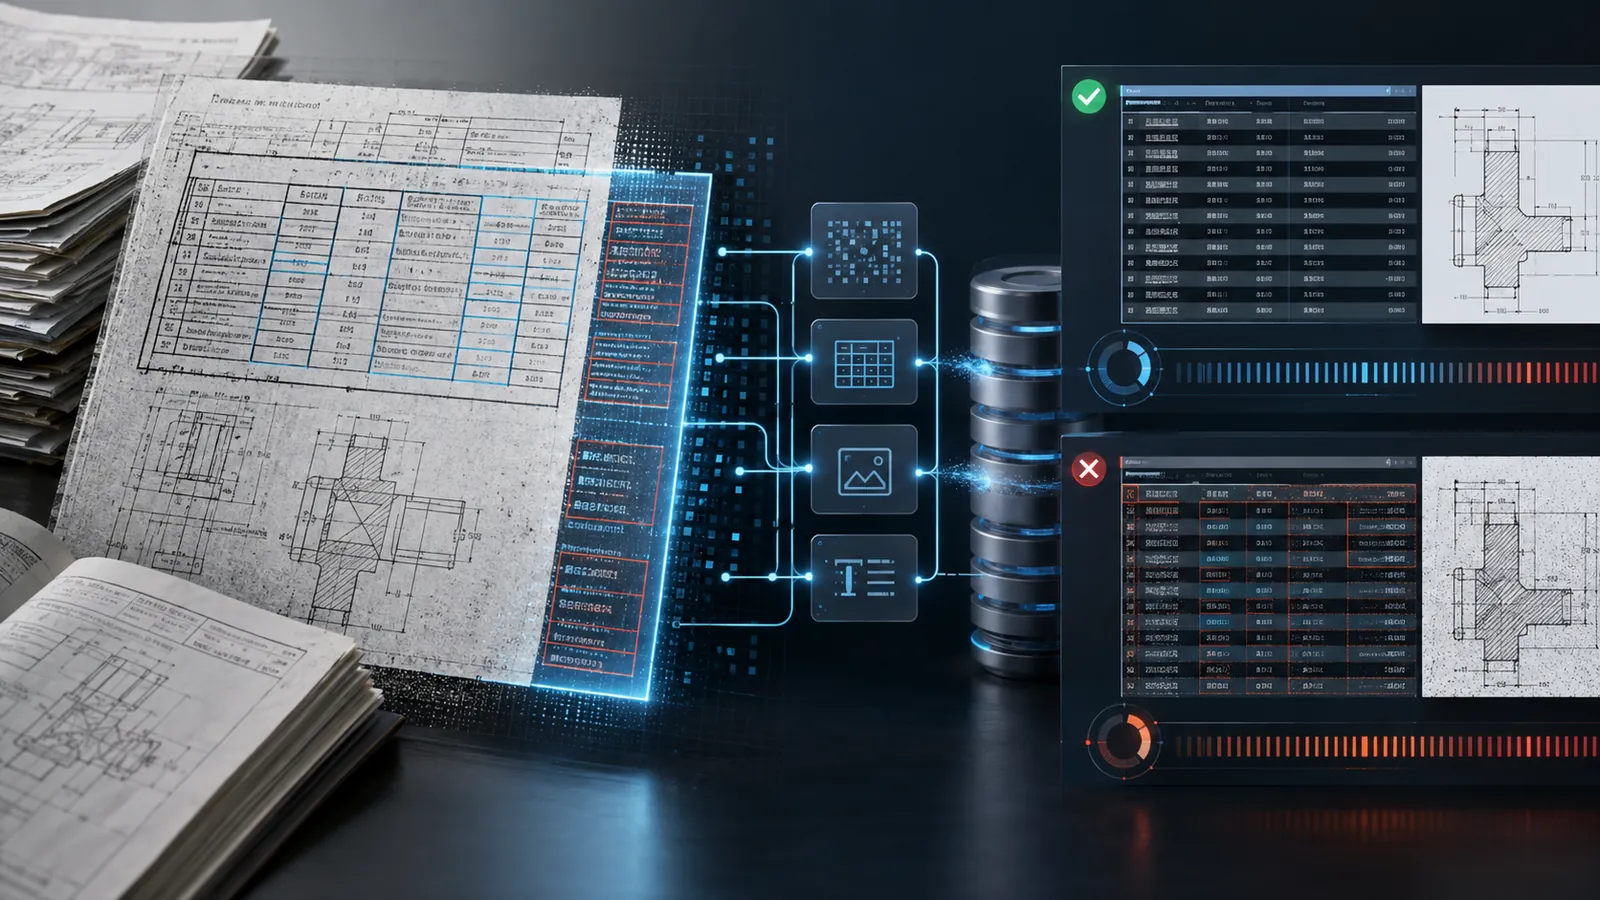
خطأ شائع عند تقييم RAG: يختبر فريق النظام على أنظف عشر ملفات PDF في الأرشيف، ويحصل على إجابات ممتازة، ثم يوقع عقدا على الأرشيف كله بناء على ذلك. بعد شهر من التشغيل الفعلي، تنخفض الدقة إلى النصف، ولا أحد يستطيع تفسير السبب. غالبا ما يكون السبب ليس النموذج، بل أن «بقية» الأرشيف يتكون في معظمه من مسوح وجداول بخلايا مدمجة ووثائق بلا طبقة نصية على الإطلاق.
لا يتعطل RAG عند توليد الإجابة بل قبل ذلك بخطوات — عند استخراج النص. يمكن لمسح مشوش، أو جدول ببنية معقدة، أو رسم هندسي أن يحوّل وثيقة دقيقة المحتوى إلى فهرس ضعيف قبل أن يعمل الاسترجاع أصلا.
تؤكد الأبحاث ذلك: أظهر OHRBench أن جودة OCR تنتقل كسلسلة عبر الأنبوب بأكمله — يحصل الاسترجاع على ضوضاء بدل النص، وتقارن إعادة الترتيب مقاطع ناقصة، ويكتب التوليد إجابة واثقة من بيانات تالفة. ووجد HD-RAG بشكل منفصل أن الجداول ذات الخلايا المدمجة تحتاج تحليلا مخصصا يراعي بنية الجدول، لا OCR سطرا بسطر. ويبين معيار UDA على الوثائق الواقعية أن ملفات PDF العادية متعددة الأعمدة ذات الحواشي تحقق نتائج أضعف بوضوح من corpus نصي نظيف، حتى مع نفس النموذج.
ينتج عن ذلك استنتاج مباشر: عشر ملفات PDF نظيفة لا تقول شيئا عن مدى جاهزية الأرشيف كله. يجب أن تشمل التجربة ذات المعنى ليس أفضل الوثائق بل الوثائق النموذجية — المسوح والجداول والمرفقات متعددة الصفحات التي سيسأل عنها المستخدمون فعلا.
قبل إطلاق أي تجربة، يستحق الأمر تقييم الأرشيف بصدق على أربعة محاور: ما نسبة المسوح بلا طبقة نصية؛ هل توجد جداول ببنية معقدة؛ هل تُحفظ أرقام الصفحات بعد التحويل؛ وهل يمكن الإحالة إلى صف محدد في جدول لا إلى الملف كله فقط. إجابة «لا نعرف» عن أي من هذه الأسئلة إشارة إلى أن تقييم الأرشيف يجب أن يحدث قبل التجربة، لا بعدها.
يجعل Knovium هذا التقييم جزءا صريحا من التحضير: تُصنَّف كل وثيقة في الأرشيف حسب فئة جودة المصدر — «نص نظيف»، «PDF»، «مسح»، «جدول معقد» — ويكون هذا التصنيف مرئيا للعميل قبل أن يبدأ النظام في الإجابة عن الأسئلة، لا أن يظهر كعذر بعد أول إجابات ضعيفة.