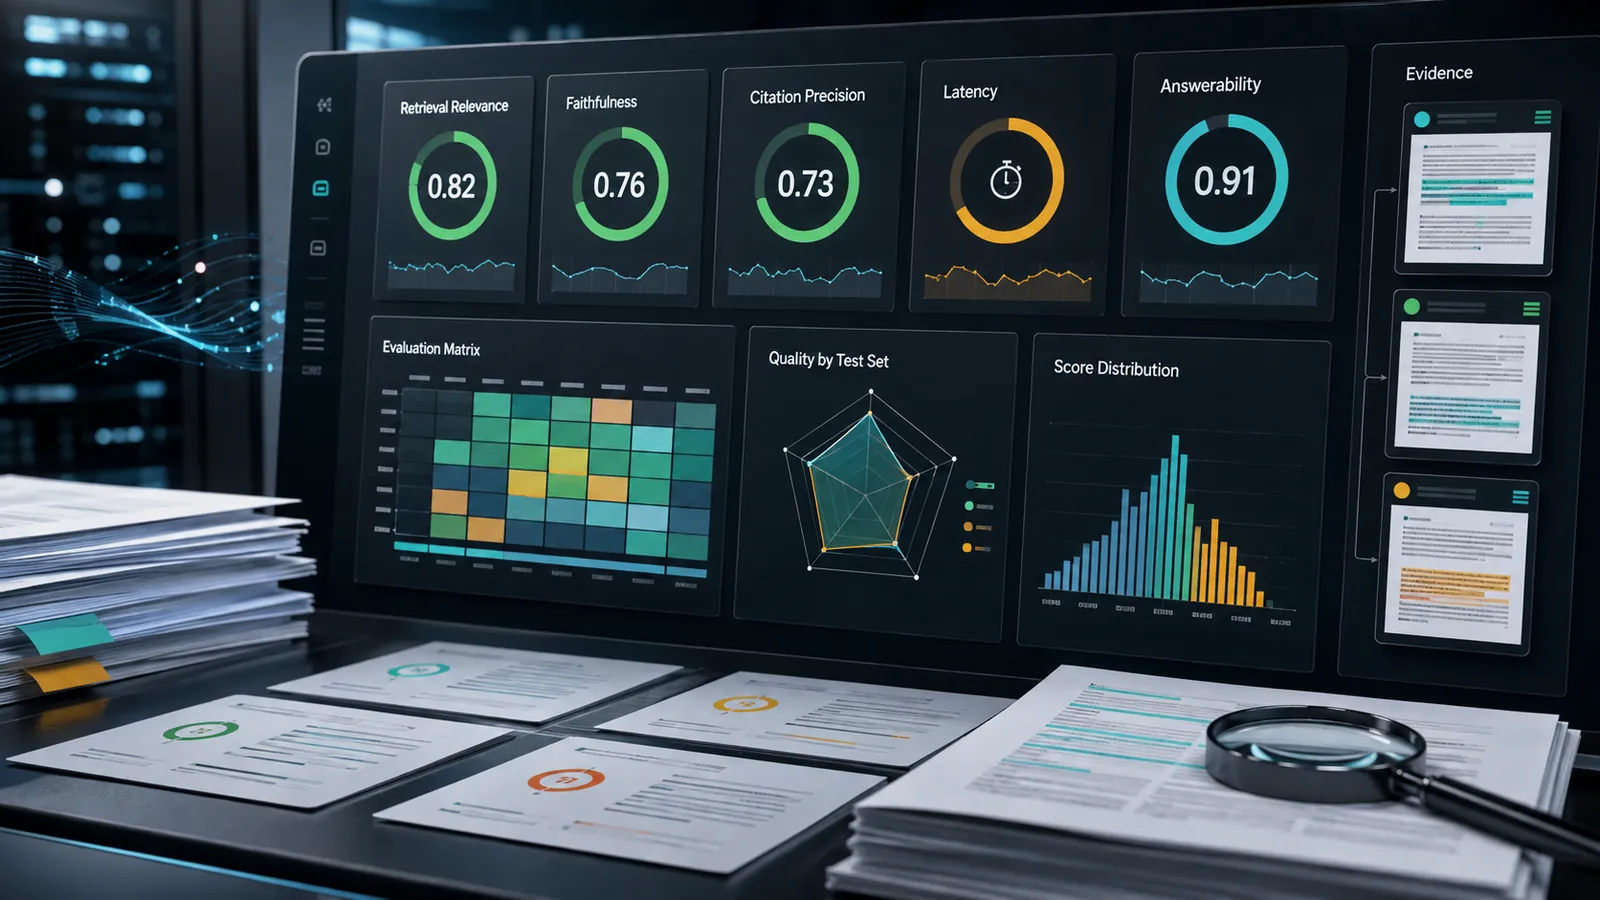
«التجربة سارت جيدا» — جملة لا تعني شيئا لمهندس أو محام أو مدير مالي. جيدا كيف؟ هل كانت الإجابات دقيقة؟ في الأسئلة الخمسين جميعها أم في 30 منها فقط؟ هل اختُبر النظام على الأسئلة التي يطرحها المستخدمون فعلا، أم على تلك التي يسهل عرضها في تجربة توضيحية؟
الفرق بين «أعجبنا» و«اجتاز القبول» هو مصفوفة مقاييس، لا انطباع ذاتي من بضع إجابات جميلة الشكل. يجب التحقق بشكل منفصل: هل وُجدت الوثيقة الصحيحة، هل الإحالة صحيحة، هل يجيب النص عن السؤال بالكامل، هل يضيف النموذج شيئا من عنده، وهل تصل الإجابة في وقت مقبول.
تفصل دراسات تقييم RAG — Yu وزملاؤه (2024)، Gao وزملاؤه (2023) — هذه المستويات بوضوح: جودة الاسترجاع (هل وُجد المقطع الصحيح)، وجودة التوليد أي الأمانة (faithfulness) (مدى صدق الإجابة للسياق المسترجع)، والفائدة الشاملة للمستخدم التي لا تختزل في الاثنين الأولين وتحتاج فحصا خاصا بها.
يقف زمن الاستجابة في هذه القائمة بمفرده لأنه ليس تفصيلا تقنيا بل شرط استخدام: إجابة دقيقة تستغرق 30 ثانية قد لا تناسب سير عمل موظف التوزيع أو المهندس الميداني على الإطلاق — فيتوقف فتح النظام أصلا، مهما بلغت دقته.
قبل إطلاق أي تجربة، يستحق الأمر تثبيت ثلاثة أشياء على الورق لا في الذهن: قائمة من 30-50 سؤال ضبط بمصدر صحيح معروف مسبقا؛ حد أقصى مقبول لزمن الاستجابة يناسب سيناريو الاستخدام المحدد؛ وقاعدة صريحة لما يُعد إجابة «أدلة غير كافية» صالحة — بدلا من تسوية ذلك لاحقا بعدما يكون النظام قد اختلق شيئا بالفعل.
الفرق بين عرض توضيحي عادي وتجربة Knovium أنه هنا يمكن معرفة أين قصّر النظام مسبقا: يُحتفظ بسجل الإخفاقات والإجابات الجزئية إلى جانب الناجحة، وتُسجَّل حالات الإجابة الثلاث — موجودة، موجودة جزئيا، أدلة غير كافية — لكل سؤال ضبط، لا للتي نجحت فقط.