"Pilot iyi geçti" — bu cümle ne bir mühendise, ne bir avukata, ne de bir CFO'ya bir şey söyler. İyi ne demek? Cevaplar doğru muydu? 50 kontrol sorusunun tümünde mi, yoksa yalnızca 30'unda mı? Sistem kullanıcıların gerçekten sorduğu sorularla mı, yoksa demoda göstermesi kolay olanlarla mı test edildi?
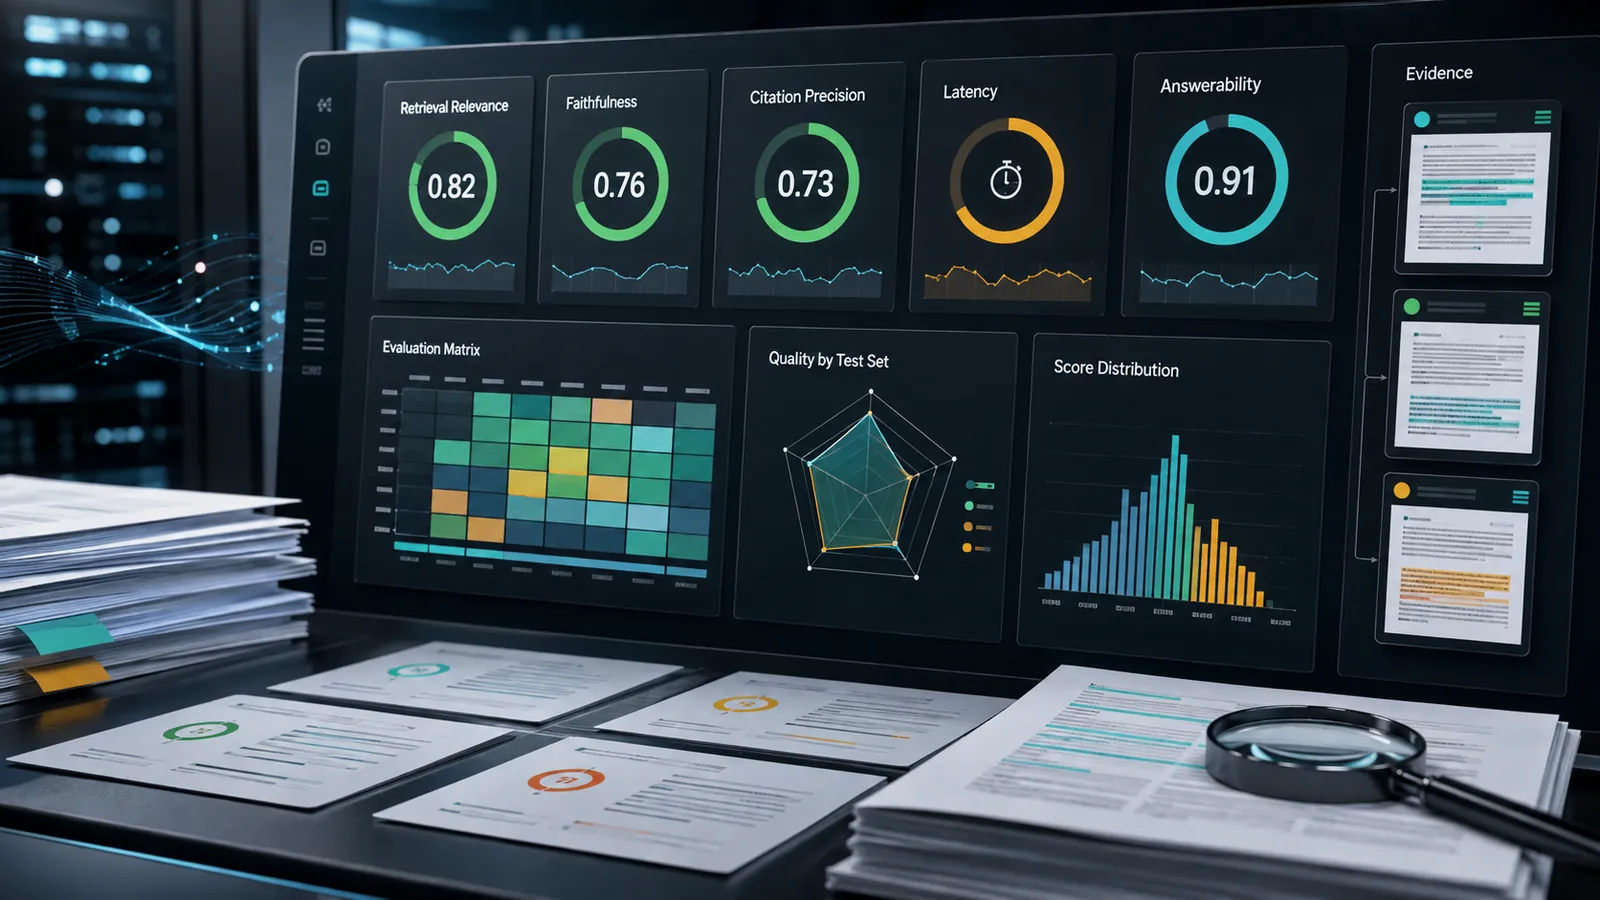
"Beğendik" ile "kabulden geçti" arasındaki fark, birkaç güzel cevaptan edinilen öznel bir izlenim değil, bir metrik matrisidir. Ayrı ayrı kontrol etmek gerekir: doğru belge bulundu mu, atıf doğru mu, metin soruyu tamamen yanıtlıyor mu, model kendinden bir şey ekliyor mu ve cevap kabul edilebilir bir sürede geliyor mu.
RAG değerlendirme incelemeleri — Yu ve arkadaşları (2024), Gao ve arkadaşları (2023) — bu seviyeleri açıkça ayırır: retrieval kalitesi (doğru pasaj bulundu mu), generation kalitesi yani faithfulness (cevabın bulunan bağlama ne kadar sadık olduğu) ve ilk ikisine indirgenemeyen, kendi başına kontrol gerektiren uçtan uca kullanıcı faydası.
Latency bu listede ayrı durur, çünkü teknik bir ayrıntı değil bir kullanım koşuludur: 30 saniyede gelen doğru bir cevap bile bir sevkiyatçının veya sahadaki mühendisin iş akışına hiç uymayabilir — ve sistem ne kadar doğru olursa olsun artık açılmaz olur.
Bir pilot başlatmadan önce üç şeyi kafada tutmak yerine kâğıda geçirmek gerekir: bilinen doğru kaynağa sahip 30-50 kontrol sorusundan oluşan bir liste; belirli kullanım senaryosu için kabul edilebilir bir latency eşiği; ve sistem bir şeyi uydurduktan sonra değil önceden, "yetersiz kanıt" cevabının ne zaman geçerli sayılacağına dair açık bir kural.
Sıradan bir demo ile bir Knovium pilotu arasındaki fark şudur: burada sistemin tam olarak nerede yetersiz kaldığı önceden görülür — hata ve kısmi cevap günlüğü başarılı olanlarla birlikte tutulur, ve cevabın üç durumu — bulundu, kısmen bulundu, yetersiz kanıt — yalnızca iyi çıkanlar için değil, her kontrol sorusu için kaydedilir.